Biblionetka – jak odzyskać dane?

Niektórzy może pamiętają, że był taki serwis jak Biblionetka.pl, gdzie można było oceniać książki. Strona zniknęła w lipcu 2025, po ataku ransomware na grupę PWN. Najpierw nie było nic, teraz, od dłuższego czasu, jest prośba o cierpliwość.
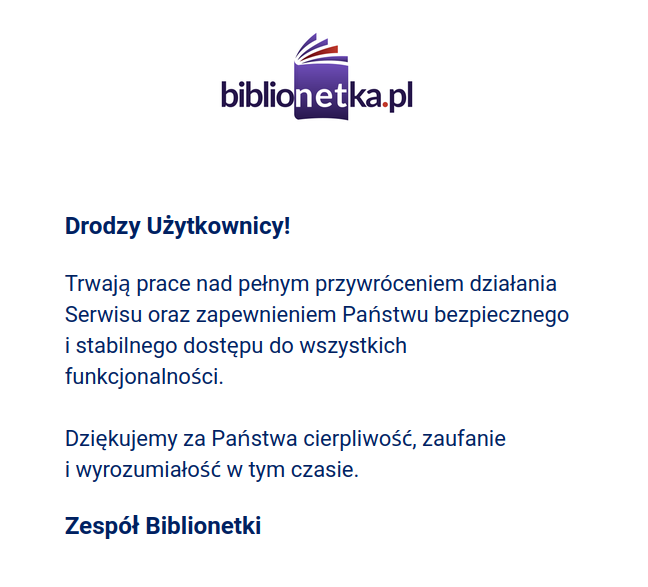
Dzisiejszy screenshot strony biblionetka.pl

Z Biblionetki korzystam „od zawsze”. Strona starego typu, taka dla fanów. Bez wszechobecnej dziś monetyzacji, bez nachalnych reklam. Po prostu działała, robiła robotę. Była wg mnie najlepszym serwisem tego typu w Polsce, z największą ilością pozycji, szczególnie polskich. Sam dodałem jakieś… Nie było fancy API, ale nie przeszkadzało to ludziom w robieniu zewnętrznych polecajek[1].

I wszystko się nagle, po ataku ransomware, skończyło. Niby miałem skrypt do backupu ocen ale… Tak, zgadliście, nie był to element backupu, który miałem zautomatyzowany. Więc nie wykluczam, że gdzieś miałem jakiś snapshot moich ocen[2]. Ale dane jakby przepadły. Nic krytycznego, niby, ale fajnie było je mieć. Parę razy złapałem się na tym, że chciałem sprawdzić jak mi się książka podobała i… nie mogłem.

Wiadomo, można poczekać, aż przywrócą. Jednak cierpliwość mi się skończyła i stwierdziłem, że pora spróbować odzyskać dane, bo minął już rok. Tym bardziej, że PWN oberwało mocno tym atakiem – między innymi wydawnictwo Azymut zakończyło działalność hurtową, więc do niszowego/fanowskiego serwisu nieprędko – jeśli w ogóle – będzie miał tam ktoś do tego głowę/zasoby.

Zatem jak odzyskać dane z serwisu Biblionetka.pl? Postanowiłem skorzystać ze znanego patentu stosowanego przez niektórych przy KRD i sprawdzić, czy da się odzyskać dane na podstawie RODO[3]. Na adres IOD grupy PWN wysłałem wniosek o udostępnienie danych. Ponieważ była to moja pierwsza prośba tego typu, dla mej pamięci – i żebyście Wy nie musieli szukać – treść, a jednocześnie dość uniwersalny gotowiec, poniżej.

Na podstawie art. 15 rozporządzenia 2016/679 (RODO) wnoszę o udzielenie mi dostępu do wszystkich moich danych znajdujących się w serwisie biblionetka.pl, którego jestem użytkownikiem oraz kopii tych danych w formie elektronicznej na adres e‑mail:

Dane identyfikacyjne:
– imię i nazwisko:
– adres e‑mail w serwisie:
– login / nazwa użytkownika:

Proszę o realizację wniosku w terminie wskazanym w art. 12 ust. 3 RODO.

Tyle wystarczyło. Początek był nieco dziwny (komunikat BOK o skierowaniu danych do wydawnictwa), ale po kilkunastu dniach i wymianie paru maili (potrzebny był jeszcze nr telefonu do przesłania hasła do pliku zip z eksportem) otrzymałem zamówione dane w formie pliku xlsx. W tym to, na czym najbardziej mi zależało, czyli wszystkie oceny książek i daty ocen. I to do lipca 2025 włącznie[4], czyli albo nie było strat danych, albo jakieś minimalne, rzędu kilku dni. Co jest oczywiście wspaniałą wiadomością i daje nadzieję na przywrócenie serwisu – najważniejsza rzecz, czyli dane, są.

Proces przygotowania danych wygląda na całkowicie manualny, więc – jeśli zdecydujecie się pobrać dane – nie spieszcie się ze składaniem wniosków i bądźcie wyrozumiali, gdyby nastąpiły opóźnienia.

Mam oczywiście nadzieję, że Biblionetka powróci – to był prosty, szybki serwis, z dużą ilością danych po polsku. Z dzisiejszej perspektywy patrząc: perełka, której może nieco brakowało rozgłosu. Trzymam kciuki i liczę na powrót. Póki co będę uzupełniał oceny w pliku…

UPDATE: Jeśli dobrze widzę w mailach, incydent cyberbezpieczeństwa miał miejsce 21.07.2025.

[1] Strona z poleceniami przestała działać jeszcze jakiś czas przez awarią Biblionetki.
[2] Pewnie z 2021, gdy napisałem skrypt, skoro nie było zautomatyzowane…
[3] O ile w ogóle są dostępne po ataku ransomware, różne rzeczy widziałem…
[4] Najnowsza ocena, którą mam, to 13.07.2025.

GitHub backup

Od dłuższego czasu poruszany jest w różnych miejscach temat niezależności technologicznej od firm z… innych obszarów prawnych, że tak to ujmę. W szczególności chodzi o firmy spoza Europy. Jest też – nieco niezależny, choć w praktyce często zbieżny – temat uniezależnienia się do wielkich korporacji. Bo jakoś tak się złożyło, że wielkie korporacje nie są europejskie.

Przyznaję, że kibicuję obu tematom. I o ile nie czuję, że muszę koniecznie już teraz przenieść wszystkie zabawki do Europy, to… chcę mieć w razie czego taką możliwość. Pomału się rozglądam, wykonuję pewne drobne – póki co – ruchy. W szczególności jeśli z jakiegoś powodu rezygnuję z jakiejś usługi, to szukam alternatywy w Europie.

Tyle kontekstu, ale przecież miało być o backupie GitHub. Jak powszechnie wiadomo, jest to usługa Microsoftu, czyli podlegająca prawu USA. I w dodatku należąca do jednej z największych korporacji na świecie. Znaczy mogą zrobić z kodem co chcą, w tym… zniknąć go. Zamknąć dowolne konto. Usunąć dowolne repozytorium (i wszystkie jego forki). Bo tak.

Zapewne się to nie wydarzy, jeśli chodzi o moje repozytoria ale… Nie wiadomo. Bo już różne rzeczy były z GitHub usuwane. Więc ktoś kiedyś może wpaść na pomysł, że np. bruteforce PESELi to groźne narzędzie i trzeba repozytorium – albo i całe konto – usunąć. Wolę więc mieć możliwość przywrócenia swojego kodu z backupu. Backup serwerów i tak robię, wiele własnego kodu nie mam. Więc zrobienie kopii repozytoriów do katalogu, który jest objęty backupem wygląda jak proste, lekkie rozwiązanie.

Jeśli chodzi o ewentualne zastępstwo dla GitHuba, wybrałem popularną alternatywę w postaci europejskiego Codeberg.org[1]. Na którym i tak założyłem już wcześniej konto z uwagi na pewien pull request, który chciałem zrobić.

Repozytoriów trochę mam, są one publiczne, więc postanowiłem zautomatyzować robienie backupu, żeby nie musieć pamiętać o dodaniu każdego nowego repozytorium do skryptu robiącego backup. Po prostu robię backup wszystkich publicznych repozytoriów należących do danego użytkownika GitHub. Oczywista konsekwencja – i wada rozwiązania – jest taka, że jeśli zrobię fork jakiegoś większego projektu, to także on trafi do backupu. Jednak nie jest to częsta sytuacja, a nawet te większe projekty nie są aż tak duże, żeby mi to przeszkadzało.

Skrypt github-backup jest – jak widać – bardzo prosty. Wymaga zewnętrznego programu git i tylko jednej biblioteki – requests. Zasada działania skryptu github-backup jest prosta. Przechodzimy do katalogu ze skryptem. Podajemy usera jako parametr. W katalogu, w którym jest uruchamiany skrypt, najpierw tworzony jest katalog o takiej nazwie, jak nazwa użytkownika[2]. Następnie pobierana jest lista publicznych repozytoriów użytkownika. A w końcu dla każdego z nich tworzona jest kopia przy pomocy zewnętrznego polecenia git clone –mirror. I tyle. Tak utworzone kopie można przywrócić na innym serwerze przy pomocy git push –mirror. Przykład w readme.

Skrypt ma wady, których nie potrzebowałem poprawiać. Po pierwsze, robi mirror do bieżącej lokalizacji. Nie jest to problem przy planowanym użyciu, czyli z użyciem cron – po prostu wcześniej trzeba zmienić katalog. Po drugie, nie obsługuje prywatnych repozytoriów. Cóż, trochę nie miałem takiej potrzeby. Poza tym, o ile dodanie klucza, który ma do nich dostęp w trybie odczyt nie jest problemem, to nad listowaniem musiałbym się zastanowić[3]. Może kiedyś, bo jak wspomniałem, obecnie nie mam takiej potrzeby.

Plany rozwoju skryptu? Dodanie obsługi innych platform przydało by się najbardziej, bo żaden dostawca ani jurysdykcja nie dają gwarancji, że konto czy repozytorium nie zniknie. Przy czym pewnie w najbliższej przyszłości skończy się na Codeberg, bo tylko tego aktualnie używam i będę miał jak przetestować. Może jednak dodanie obsługi prywatnych repozytoriów?

W każdym razie jeśli rozwiązanie komuś się przyda, to zachęcam do używania. I oczywiście robienia backupów, w tym przypadku własnego kodu. Niezależnie od metody.

UPDATE: To naprawdę prosty skrypt i główną zaletą jest brak potrzeby jakiegokolwiek uwierzytelniania, jeśli ktoś potrzebuje więcej, to istnieje np. ghorg.

[1] Ogólnie jest to serwis godny rozważenia, choć community o wiele mniejsze.
[2] Uwaga, najpierw jest usuwana cała zawartość katalogu o takiej nazwie, jeśli istnieje!
[3] No dobra, sprawdziłem, wystarczy dodać obsługę PAT (personal access token) i stosownie skonfigurować ich uprawnienia.

Mastodon backup

Kolejna w stosunkowo krótkim czasie, ale dość długa awaria jednego z liczniejszych serwerów Mastodon w Polsce, pol.social, dała okazję do bliższego przyjrzenia się możliwościom backupu. Okazało się, że ludzie się przenoszą na inne serwery i… nie jest to takie proste, szczególnie, gdy dotychczasowy serwer nie działa.

W normalnych warunkach migracja na Mastodonie polega na wskazaniu nowego miejsca, gdzie ma znaleźć się konto. Przenoszeni są m.in. obserwowani, obserwujący, ale treści (tooty, czyli dopowiednik postów) zostają na starym serwerze. Nie ma możliwości przeniesienia treści na nowy serwer, przynajmniej oficjalnej. Zresztą byłoby to trudne, bo wszystkie istniejące odnośniki do niej, wątki, i tak przestaną działać. Kwestia niezbyt szczęśliwego projektu protokołu.

Istnieje nieoficjalne rozwiązanie slurp, które zostało zaprojektowane do działania z GoToSocial. Jeden serwerów ActivityPub, raczej pomyślany o małych, samodzielnie utrzymywanych instancjach. Polega na umieszczeniu starych tootów na serwerze z oryginalnymi datami. Wątki i odnośniki nadal przestają działać, jeśli serwer na którym były umieszczane zostanie wyłączony. Jednak można mieć przynajmniej swoje wpisy w formie „ciągłej”, razem z nowymi, które będą już pełnoprawne. Nie jest to rozwiązanie idealne, ale lepsze, niż nic.

Mastodon pozwala na wykonanie pełnej kopii, eksportu danych, raz na siedem dni:

You can request an archive of your posts and uploaded media. The exported data will be in the ActivityPub format, readable by any compliant software. You can request an archive every 7 days.

Niezależnie od tego, można – czy może bardziej: trzeba – pobierać formacie CSV dodatkowe ustawienia swojego profilu, np. obserwowanych, banowanych, bookmarki czy blokowane domeny. Trzeba, bo tych danych nie ma w tworzonym archiwum. A szkoda.

Zrobiłem prosty skrypt, który – nie wymagając logowania w przypadku publicznej widoczności – wyświetla obserwowanych. Wg mnie to najważniejsza, najtrudniej odtwarzalna informacja, poza samą treścią. Można go użyć np. w trakcie robienia backupu danych, jako jednego z elementów wykonywanych przez skrypty do backupu.

Włączyłem tworzenie archiwum i… po 20 minutach nadal wyświetlał informację, że tworzy archiwum. Przynajmniej tak pokazywała strona, bo po odświeżeniu strony jednak pojawił się gotowy do pobrania plik. Zapewne był już wcześniej, tylko błąd w Mastodon powoduje, że nie ma informacji o zakończeniu tworzenia.

Sam plik zawiera kilka plików JSON oraz drzewo katalogów z grafikami. W samych grafikach trudno się zorientować – tytuły plików i struktura katalogów nie są w formacie czytelnym dla człowieka.

Fun fact: archiwum pobrałem głównie po to, żeby łatwo móc przeszukiwać treść swoich postów. Wyszukiwarka na Mastodonie jest i niby działa, ale jednak wygodniej mi korzystać z grep w wierszu poleceń.